Sécurité

Corriger ce qui est réellement exposé, pas ce qui tombe dans le calendrier.

Le renseignement sur les correctifs et leur déploiement ne sont pas des outils raccordés à la plateforme : ils y sont intégrés, au-dessus du même référentiel. L'analyse du risque et le déploiement du correctif forment une seule chaîne, sans export ni recoupement manuel entre les deux.

Le constat

Trois outils, trois vérités, et un délai de correction qui s'allonge.

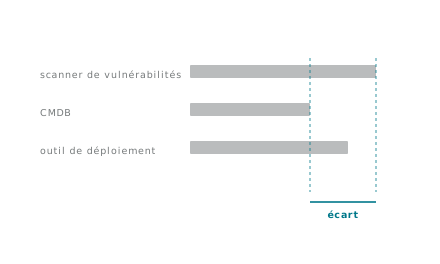
Le scanner de vulnérabilités produit une liste. La CMDB en décrit une autre. L'outil de déploiement travaille sur un troisième périmètre. Entre les trois, quelqu'un exporte, recoupe et arbitre à la main — et pendant ce temps la fenêtre d'exploitation reste ouverte.

Le problème n'est pas le nombre de CVE publiées. C'est qu'aucun de ces outils ne sait, seul, lesquelles concernent des machines réellement présentes, réellement exposées et réellement critiques dans votre parc.

L'intégration

Une seule chaîne, du risque au correctif déployé.

Le même référentiel

Patch Intelligence et Patch Management lisent l'inventaire du system of record. Pas d'export, pas de recoupement, aucun écart de périmètre entre ce qui est analysé et ce qui est corrigé.

Une priorisation qui tient compte du réel

Sévérité, existence d'un exploit connu, activité observée, et criticité métier de la machine concernée — plutôt que le seul score CVSS appliqué uniformément.

La fiabilité du correctif, avant déploiement

Patch Intelligence signale les correctifs connus pour provoquer des régressions applicatives. Vous le savez avant de les pousser, pas après.

Un déploiement gouverné

Anneaux successifs, fenêtres de maintenance négociées, populations pilotes puis généralisation. Systèmes d'exploitation et applications tierces dans le même mouvement.

Une boucle fermée

L'état après correction est reconstaté par la découverte, pas simplement déclaré par l'outil de déploiement. Le référentiel confirme — ou signale que le correctif n'a pas pris.

Une conformité démontrable

Taux de couverture, âge des correctifs manquants et exposition résiduelle sont mesurables à tout instant. C'est ce que demandent NIS 2, DORA et les auditeurs.

Le cycle

Le scan et le déploiement sont le même outil.

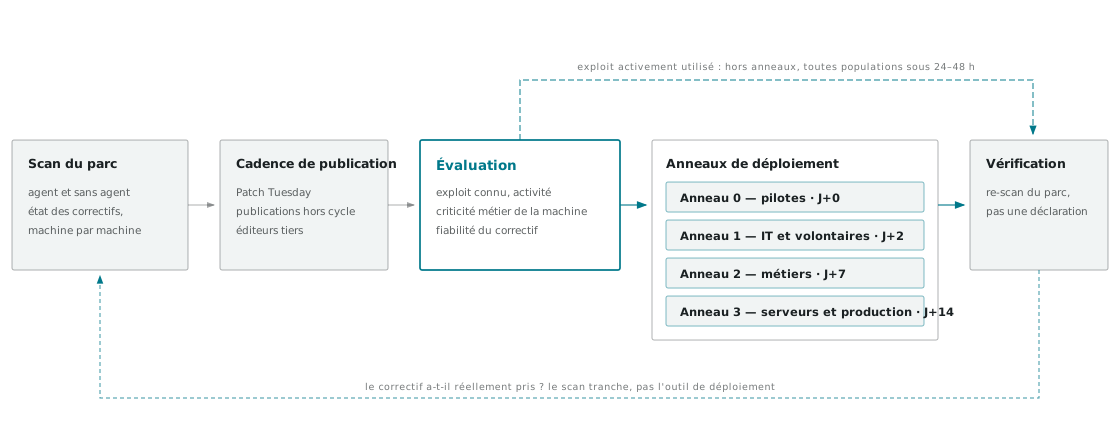
Le scan de conformité des correctifs n'est pas un produit séparé qu'il faudrait raccorder : c'est le même moteur qui constate l'état machine par machine, avec ou sans agent, et qui déclenche ensuite la campagne. Les politiques — anneaux, fenêtres, cadence Patch Tuesday, traitement hors cycle — se paramètrent une fois et s'exécutent seules.

Scan du parc → Évaluation → Anneaux de déploiement → Vérification
Le trajet réel d'un correctif. Le scan constate l'état du parc, la cadence éditeur fournit la matière, l'évaluation décide de l'ordre — puis le déploiement suit des anneaux successifs, avec un re-scan qui vérifie. La voie rapide, en pointillé, est réservée aux vulnérabilités activement exploitées : elle court-circuite les anneaux, et c'est le seul cas où elle doit le faire.

Le scan alimente directement la campagne

L'écart entre ce qui est constaté et ce qui est attendu devient la liste de travail. Aucun export, aucun rapprochement manuel entre l'outil qui mesure et celui qui corrige.

Patch Tuesday, et le reste

La cadence mensuelle de Microsoft structure le cycle, mais elle ne le résume pas : publications hors cycle, éditeurs tiers et correctifs de firmware suivent la même chaîne.

Des anneaux, pas un grand soir

Pilotes, puis IT, puis métiers, puis serveurs et production. Chaque anneau valide le suivant, et un échec arrête la progression au lieu de se propager.

Une voie rapide, strictement encadrée

Une vulnérabilité activement exploitée sort du cycle et part sur toutes les populations sous 24 à 48 heures. C'est une exception documentée, pas une habitude.

Fenêtres et retour arrière

Les fenêtres de maintenance sont négociées avec les métiers, et la procédure de retour arrière est écrite avant d'en avoir besoin — pas improvisée le soir où il faut s'en servir.

Les échecs se traitent seuls

Agent décroché, service arrêté, espace disque insuffisant : les causes récurrentes d'échec sont remédiées automatiquement plutôt que rejouées à la main chaque mois.
Ce que nous mettons en place

Du diagnostic d'exposition au reporting RSSI.

Cartographie de l'exposition

État réel du parc corrigé et non corrigé, y compris les machines que l'inventaire précédent ne voyait pas. C'est le point de départ, et il surprend souvent.

Politique de correctifs par population

Serveurs, postes nomades, postes de production, équipements en magasin : chacun a ses contraintes de disponibilité et son niveau de risque acceptable.

Anneaux, cadence et fenêtres

Anneaux de déploiement, calage sur le Patch Tuesday, fenêtres négociées avec les métiers, et procédure de retour arrière écrite avant d'en avoir besoin.

Applications tierces

La majorité des vulnérabilités exploitées ne concerne pas le système d'exploitation. Le catalogue applicatif tiers est traité au même titre.

Remédiation automatisée

Les échecs récurrents — agent décroché, service arrêté, espace disque insuffisant — sont traités automatiquement plutôt que rejoués manuellement.

Reporting pour la direction

Des indicateurs lisibles par un RSSI et par un comité de direction : exposition résiduelle, délai moyen de correction, tendance.

Les briques mobilisées

Renseignement sur les correctifsDéploiement et anneaux de correctifsContrôle de sécurité du posteGestion des mobilesRemédiation autonomeContrôle applicatifDécouverte continue
Le périmètre exact des modules dépend de vos licences et de vos environnements. Nous le cadrons au démarrage plutôt que de le supposer — et nous vous disons ce qui est déjà couvert par ce que vous détenez avant de proposer quoi que ce soit de plus.
Deux plateformes

Deux plateformes, selon la forme de votre parc.

Pour la gestion du poste de travail et des correctifs, nous déployons les deux. Elles ne visent pas le même type de parc, et le choix se fait sur le vôtre — pas sur nos habitudes.

Socle unifié poste et service

Parcs bureautiques et mobiles

Découverte continue, gestion multi-OS, mobiles sous MDM, remédiation autonome des dérives et patch piloté par le risque — le tout au-dessus du même référentiel que le service management.

Le bon choix si votre parc est surtout composé de postes de travail et de mobiles, et si vous voulez une chaîne continue du poste jusqu'au service desk.

Agent unique, très grande échelle

Parcs de serveurs et conformité continue

Un agent unique qui tient des dizaines de milliers de machines, y compris mal ou rarement connectées, avec une évaluation de conformité permanente plutôt que par campagne.

Le bon choix si vous administrez de très grands parcs de serveurs, des machines hors réseau une partie du temps, ou si la conformité continue est une obligation contractuelle ou réglementaire.

Les deux éditeurs sont nommés sur la page À propos. Porter les deux n'est pas un argument commercial : c'est ce qui nous permet de répondre honnêtement en cadrage, y compris quand la réponse ne nous arrange pas.
Recherche